
Qué ocurrió
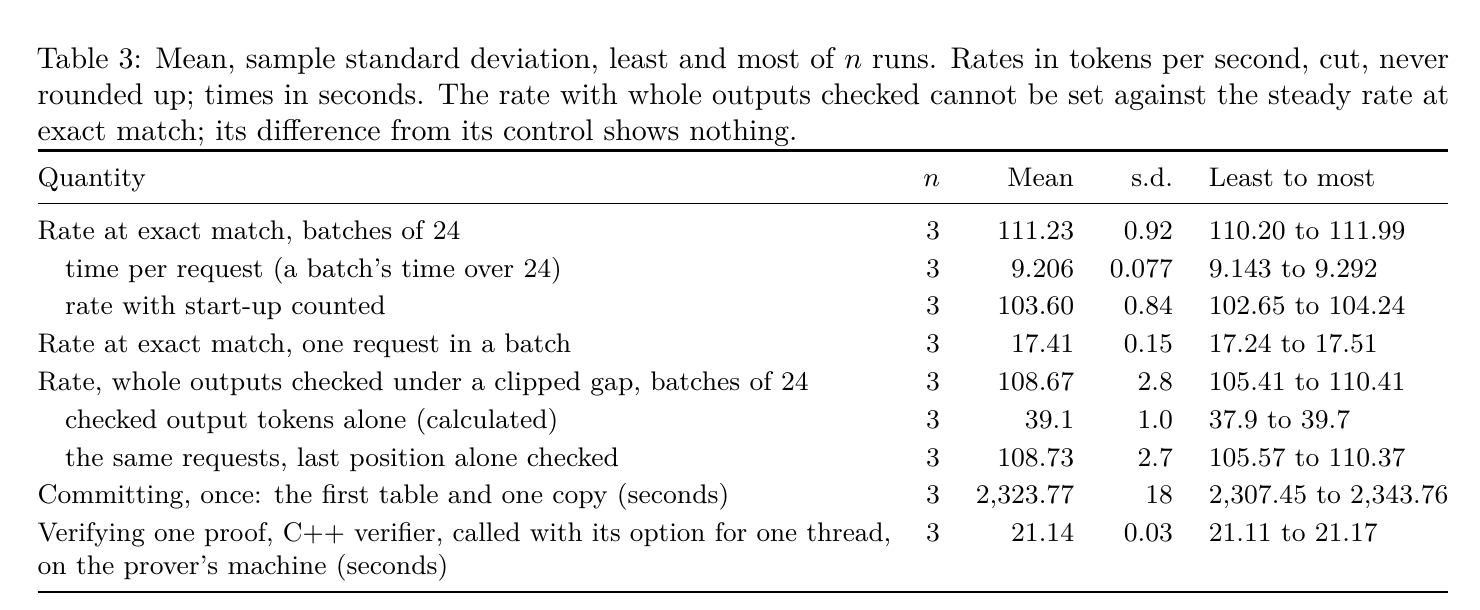
Con una versión entera de cuatro bits de Llama 4 Maverick, una H100 procesó unos 111 tokens de entrada por segundo al generar pruebas en lotes de 24 solicitudes. Con una sola solicitud, fueron unos 17. Una prueba para 1.024 tokens ocupó unos 19 MB.
Por qué importa
Se mide la generación de pruebas, no la velocidad de respuesta del chat. Los autores estiman un coste de 70 a 95 veces el tiempo de GPU de la inferencia normal. Verificar el cálculo no certifica la veracidad ni la seguridad de la respuesta.
Qué observar
Las reproducciones independientes con lotes pequeños ayudarán a evaluar el coste para servicios interactivos.
Fuentes y verificación
El número de enlaces no equivale a confirmaciones independientes.
01Informar de un error
Ayúdanos a corregir
Indica la afirmación cuestionada y, si puedes, una fuente. No envíes información personal o sensible.


