Les faits
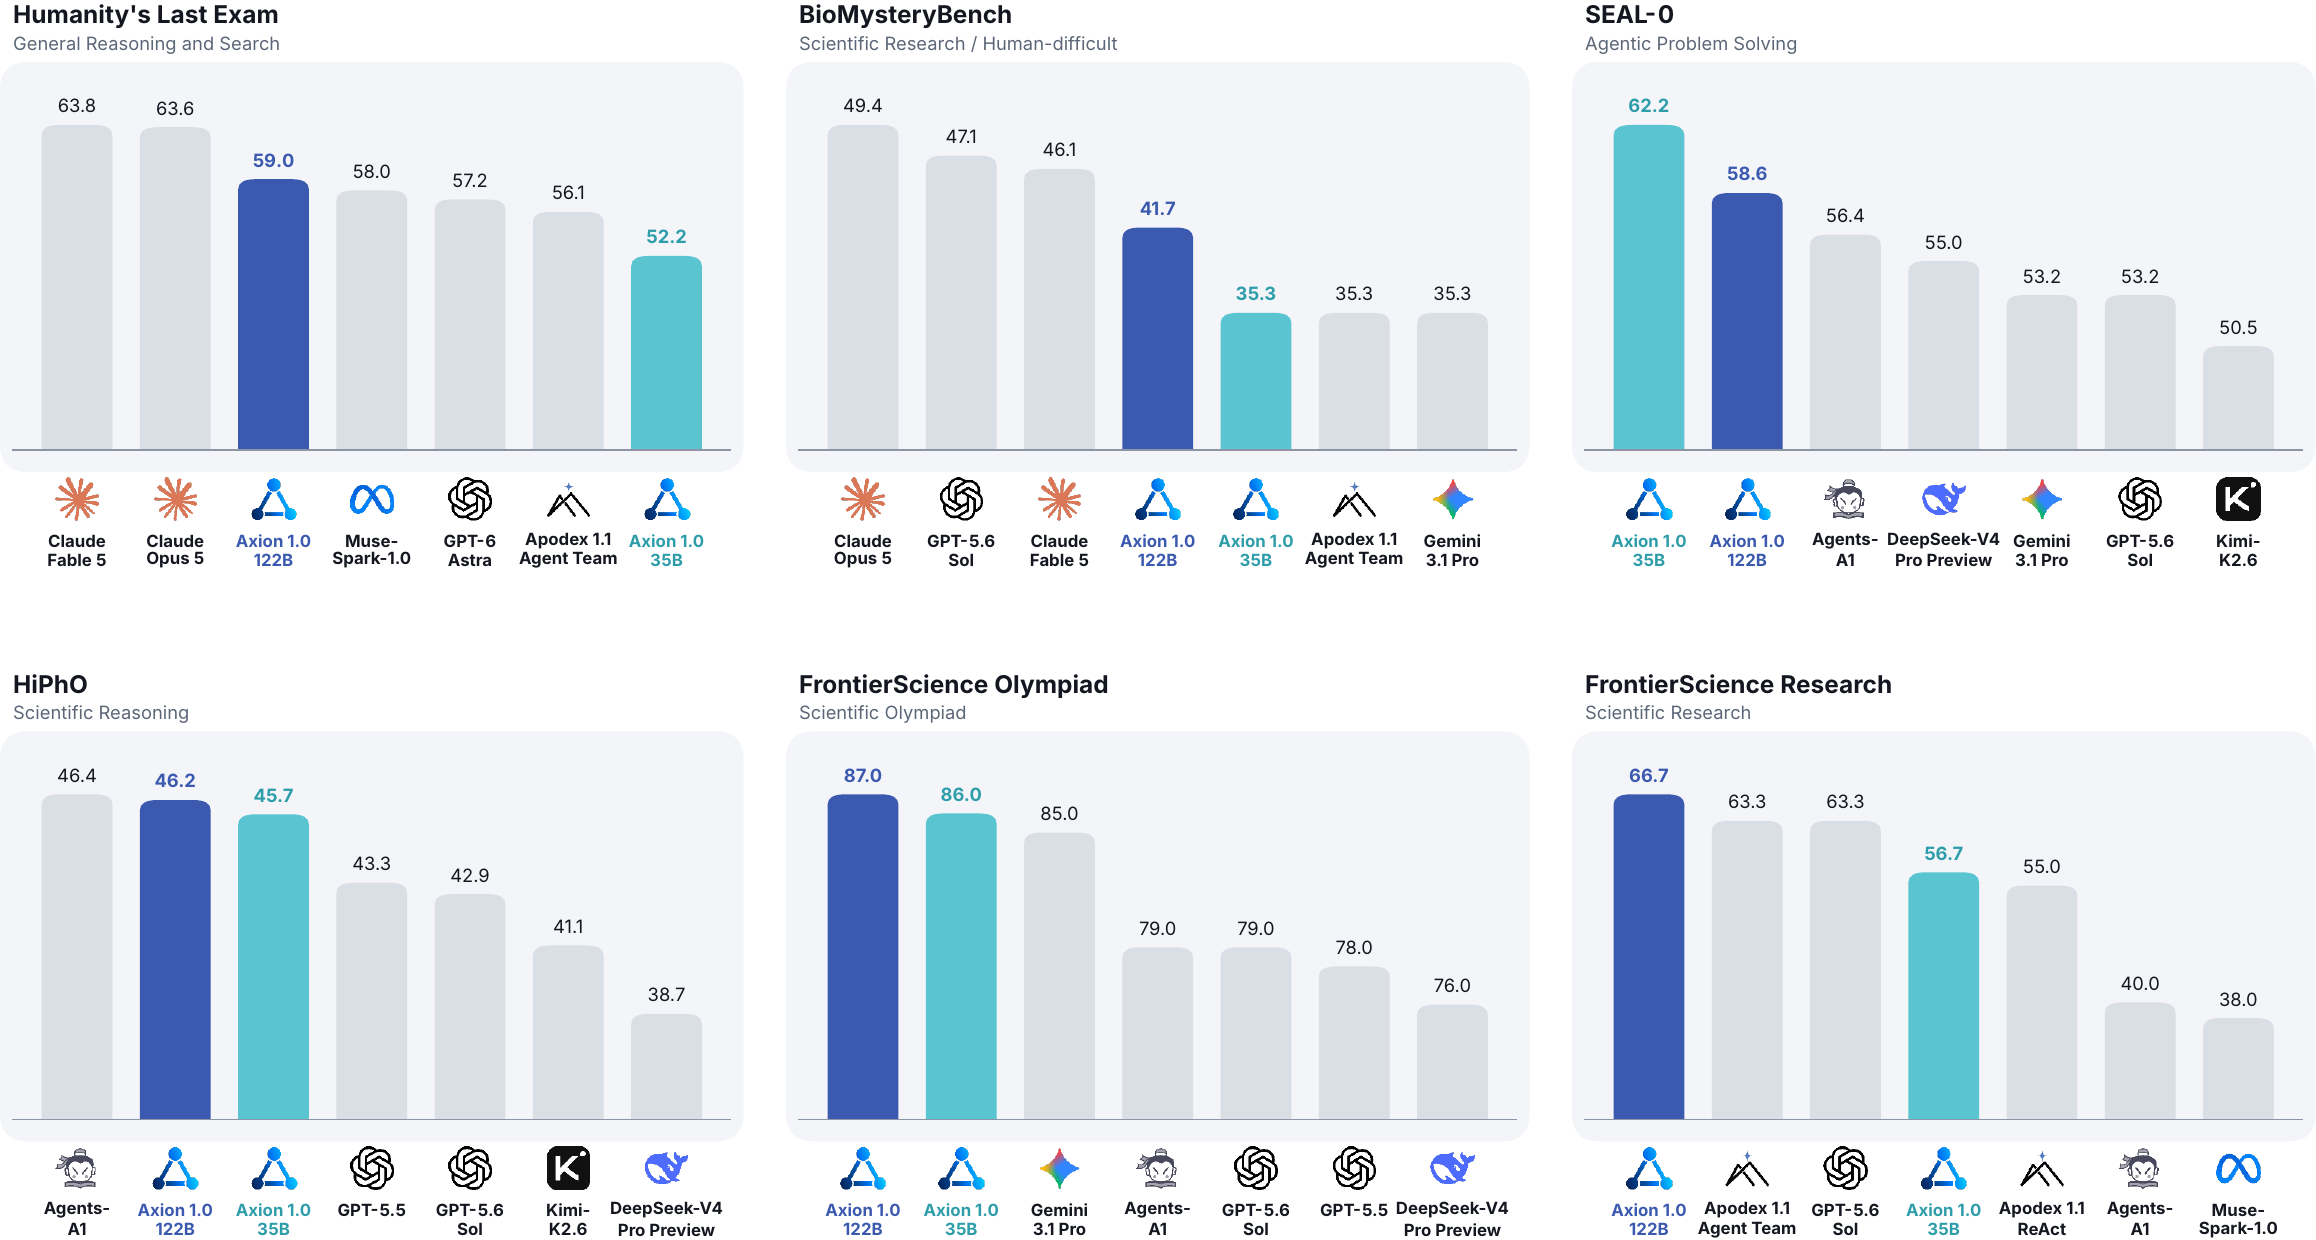
Les poids v0.4 issus de Qwen3.5-4B sont apparus le 29 octobre. Selon le dépôt, une révision du 2 novembre a supprimé l’encodeur visuel sans changer les poids linguistiques ni les réponses. La documentation du 4 novembre ajoute des évaluations et un graphique original ; il ne s’agit pas d’un modèle de base nouvellement entraîné ce jour-là.
La version Apache-2.0 répond à des questions structurées en un passage par question, au lieu de générer du texte. Ses poids actuels, limités au texte, occupent 8,41 Go. Le bon fonctionnement nécessite les masques d’attention du chargeur fourni ; une inférence causale classique modifie son comportement. Seul l’anglais a été évalué.
Macrocosmos annonce un score composite JevBench de 78,6, attribué à une mesure de Benchmark Heaven du 4 novembre. La fiche précise que le nouvel échantillon de questions n’est pas encore harmonisé avec le classement public : les comparaisons directes demandent donc prudence. Elle révèle aussi une sélection du checkpoint sur un test public et des chevauchements textuels dans une autre évaluation.
Pourquoi c’est important
Ces modèles peuvent limiter la génération inutile de texte pour le routage et la classification. Leurs probabilités doivent toutefois être validées sur les tâches visées. Compatibilité d’exécution et comparabilité des tests comptent autant que le score ; rapidité et classement ne garantissent pas des décisions professionnelles fiables.
À surveiller
À suivre : une entrée dans le classement harmonisé, des essais indépendants et la prise en charge par les moteurs d’inférence courants.
Sources et vérification
Les liens ne correspondent pas nécessairement à des confirmations indépendantes.
01Signaler une correction
Aidez-nous à corriger
Indiquez l’affirmation contestée et si possible une source. N’envoyez pas de données personnelles ou sensibles.