
Wat is er gebeurd
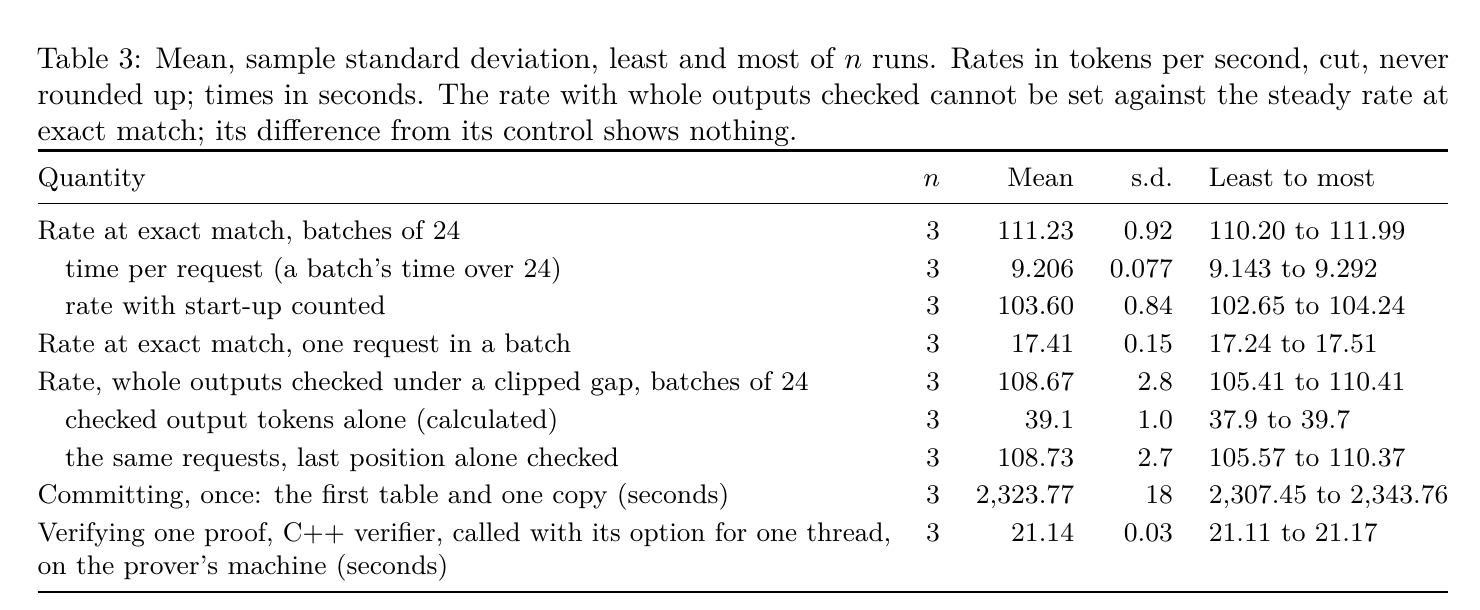
Met een vierbitsgeheelgetalversie van Llama 4 Maverick verwerkte één H100 circa 111 invoertokens per seconde voor de bewijzen bij groepen van 24 verzoeken. Bij één verzoek was dat circa 17. Een bewijs voor 1.024 tokens besloeg ongeveer 19 MB.
Waarom het belangrijk is
Dit is bewijssnelheid, geen uitvoersnelheid van een chatbot. In de vergelijking van de auteurs kostte het bewijs 70 tot 95 keer zoveel GPU-tijd als gewone inferentie. Het bewijst een berekening, niet dat het antwoord juist of veilig is.
Wat we volgen
Onafhankelijke herhalingen met kleine groepen verzoeken kunnen uitwijzen wat de techniek betekent voor interactieve diensten.
Bronnen en verificatie
Het aantal bronlinks is niet het aantal onafhankelijke bevestigingen.
01Meld een correctie
Help ons fouten te herstellen
Vermeld de betwiste uitspraak en zo mogelijk een bronlink. Stuur geen persoonlijke of gevoelige gegevens.


