
O que aconteceu
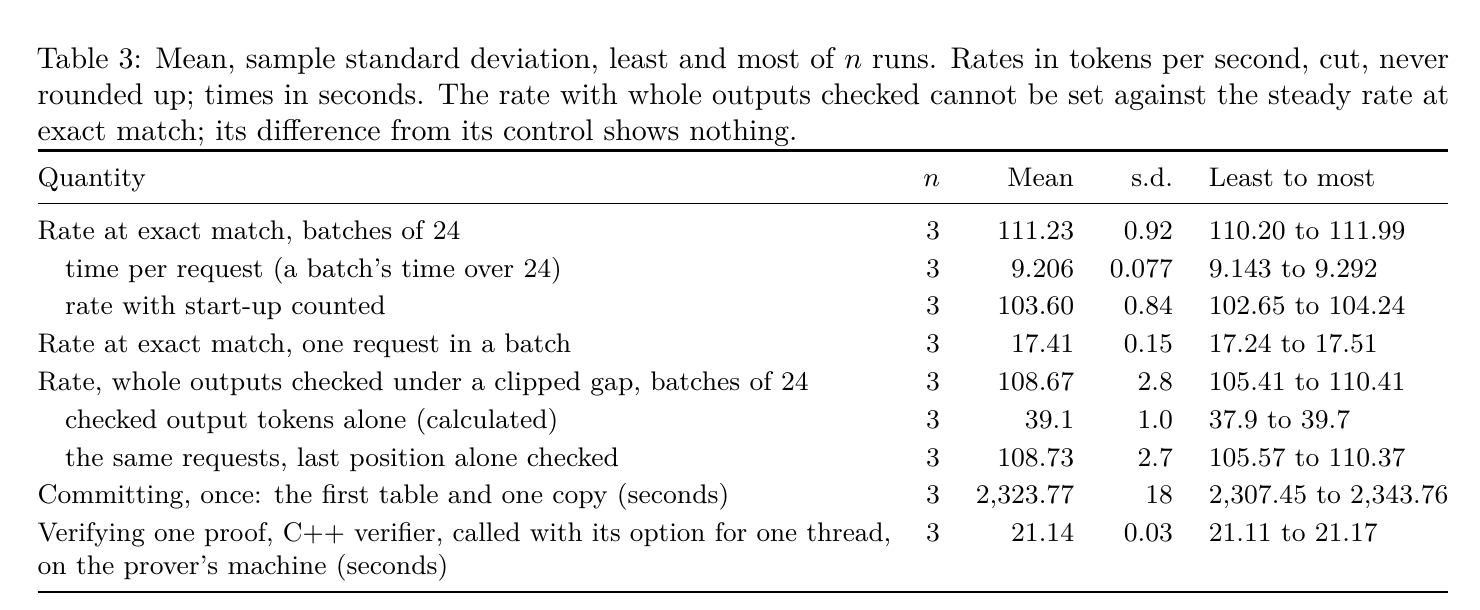
Com uma versão inteira de quatro bits do Llama 4 Maverick, uma H100 processou cerca de 111 tokens de entrada por segundo para gerar provas em lotes de 24 solicitações. Com uma única solicitação, foram cerca de 17. A prova de uma solicitação de 1.024 tokens ocupou aproximadamente 19 MB.
Por que importa
O teste mede geração de provas, não a velocidade de resposta de um chatbot. Na comparação dos autores, a prova consumiu de 70 a 95 vezes o tempo de GPU da inferência comum. Confirmar um cálculo não atesta que a resposta seja verdadeira ou segura.
O que acompanhar
Reproduções independentes com lotes pequenos serão importantes para avaliar o custo em serviços interativos.
Fontes e verificação
Links de fontes não representam necessariamente confirmações independentes.
01Informar correção
Ajude-nos a corrigir
Indique a afirmação contestada e, se possível, uma fonte. Não envie informações pessoais ou sensíveis.


