
Что произошло
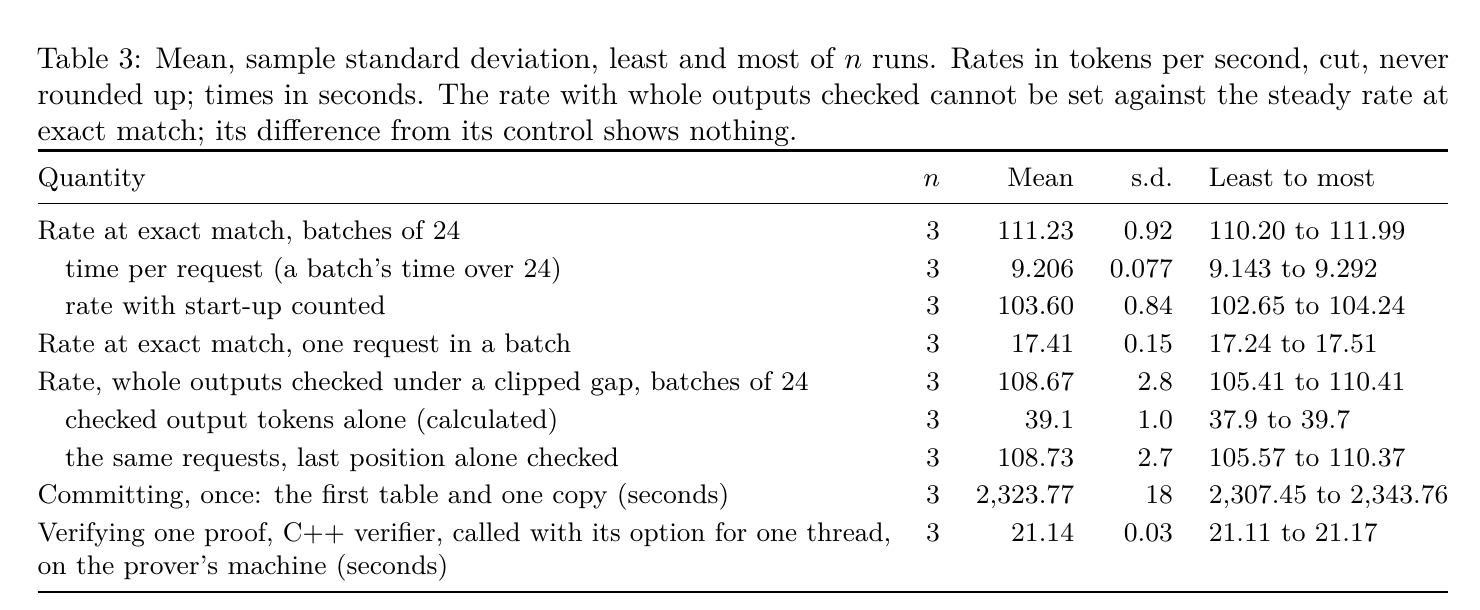
Для четырёхбитной целочисленной версии Llama 4 Maverick одна H100 обрабатывала при построении доказательств около 111 входных токенов в секунду в пакетах по 24 запроса. При одном запросе — около 17. Доказательство для 1 024 токенов занимало примерно 19 МБ.
Почему это важно
Это скорость построения доказательства, а не генерации ответа. В сравнении авторов затраты времени GPU превышали обычный вывод в 70–95 раз. Доказательство подтверждает заданное вычисление, но не истинность и не безопасность ответа.
За чем следить
Для интерактивных сервисов особенно важны независимые измерения на одиночных запросах и небольших пакетах.
Источники и проверка
Количество ссылок не равно количеству независимых подтверждений.
01Сообщить об ошибке
Помогите исправить ошибку
Укажите спорное утверждение и по возможности источник. Не отправляйте личную или чувствительную информацию.


