
此文补充此前遗漏的报道。原始来源日期列于下方,并非今日新发布的消息。
发生了什么
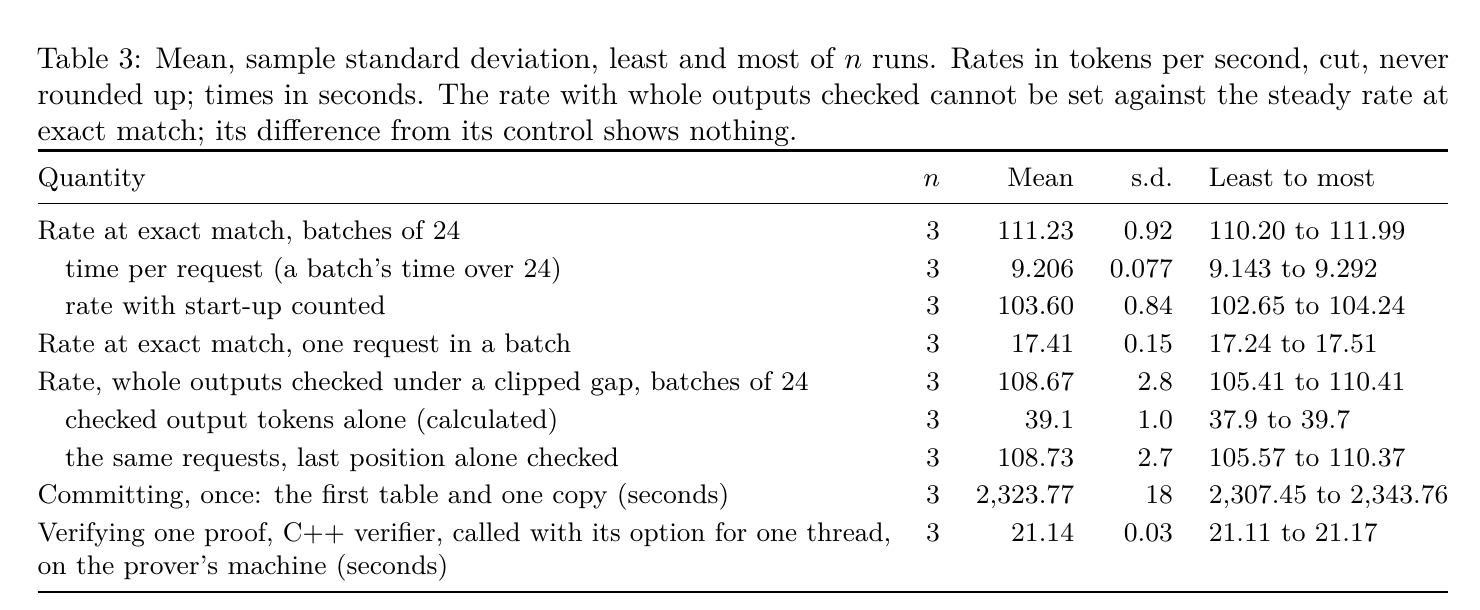
研究团队使用四位整数版本的Llama 4 Maverick测试:单张H100在每批24个请求时,生成证明的吞吐量约为每秒111个输入词元;每批只有一个请求时约为17个。一个1024词元请求的证明约占19 MB。
为何重要
这里测量的是生成证明的吞吐量,并非聊天机器人的输出速度。在作者的对比中,证明耗费的GPU时间约为普通推理的70至95倍。证明能核对特定计算是否执行,却不能说明回答真实或安全。
后续关注
对于无法等待大量请求凑成一批的交互服务,独立复现和小批量测试结果将尤其重要。
来源与核实
来源链接数量不等于独立证实次数。
01Anthropic and collaborators — original research announcement一手来源 · www.anthropic.com · 2026年11月2日
02FlashProve technical report, Table 3 and evaluation conditions一手来源 · github.com · 2026年11月2日
报告错误
帮助我们纠错
请指出争议陈述,并尽可能提供来源链接。请勿发送个人或敏感信息。


