此文补充此前遗漏的报道。原始来源日期列于下方,并非今日新发布的消息。
发生了什么
Linum在11月4日的公告中介绍了一款约20亿参数的图像生成模型,训练使用6.6亿个样本。所称2.1万美元是训练算力成本,而不是开发商业产品的全部成本。代码和权重采用Apache 2.0许可证。
代码库描述了使用Qwen3.5-4B文本编码器的CUDA流程。图像模型的fp32权重为8.7 GB,编码器的bf16权重为8 GB,均不含激活内存。支持的五种图像尺寸约为一百万像素。默认提示词扩写步骤调用外部付费模型,但用户可以提供详细描述以跳过该步骤。
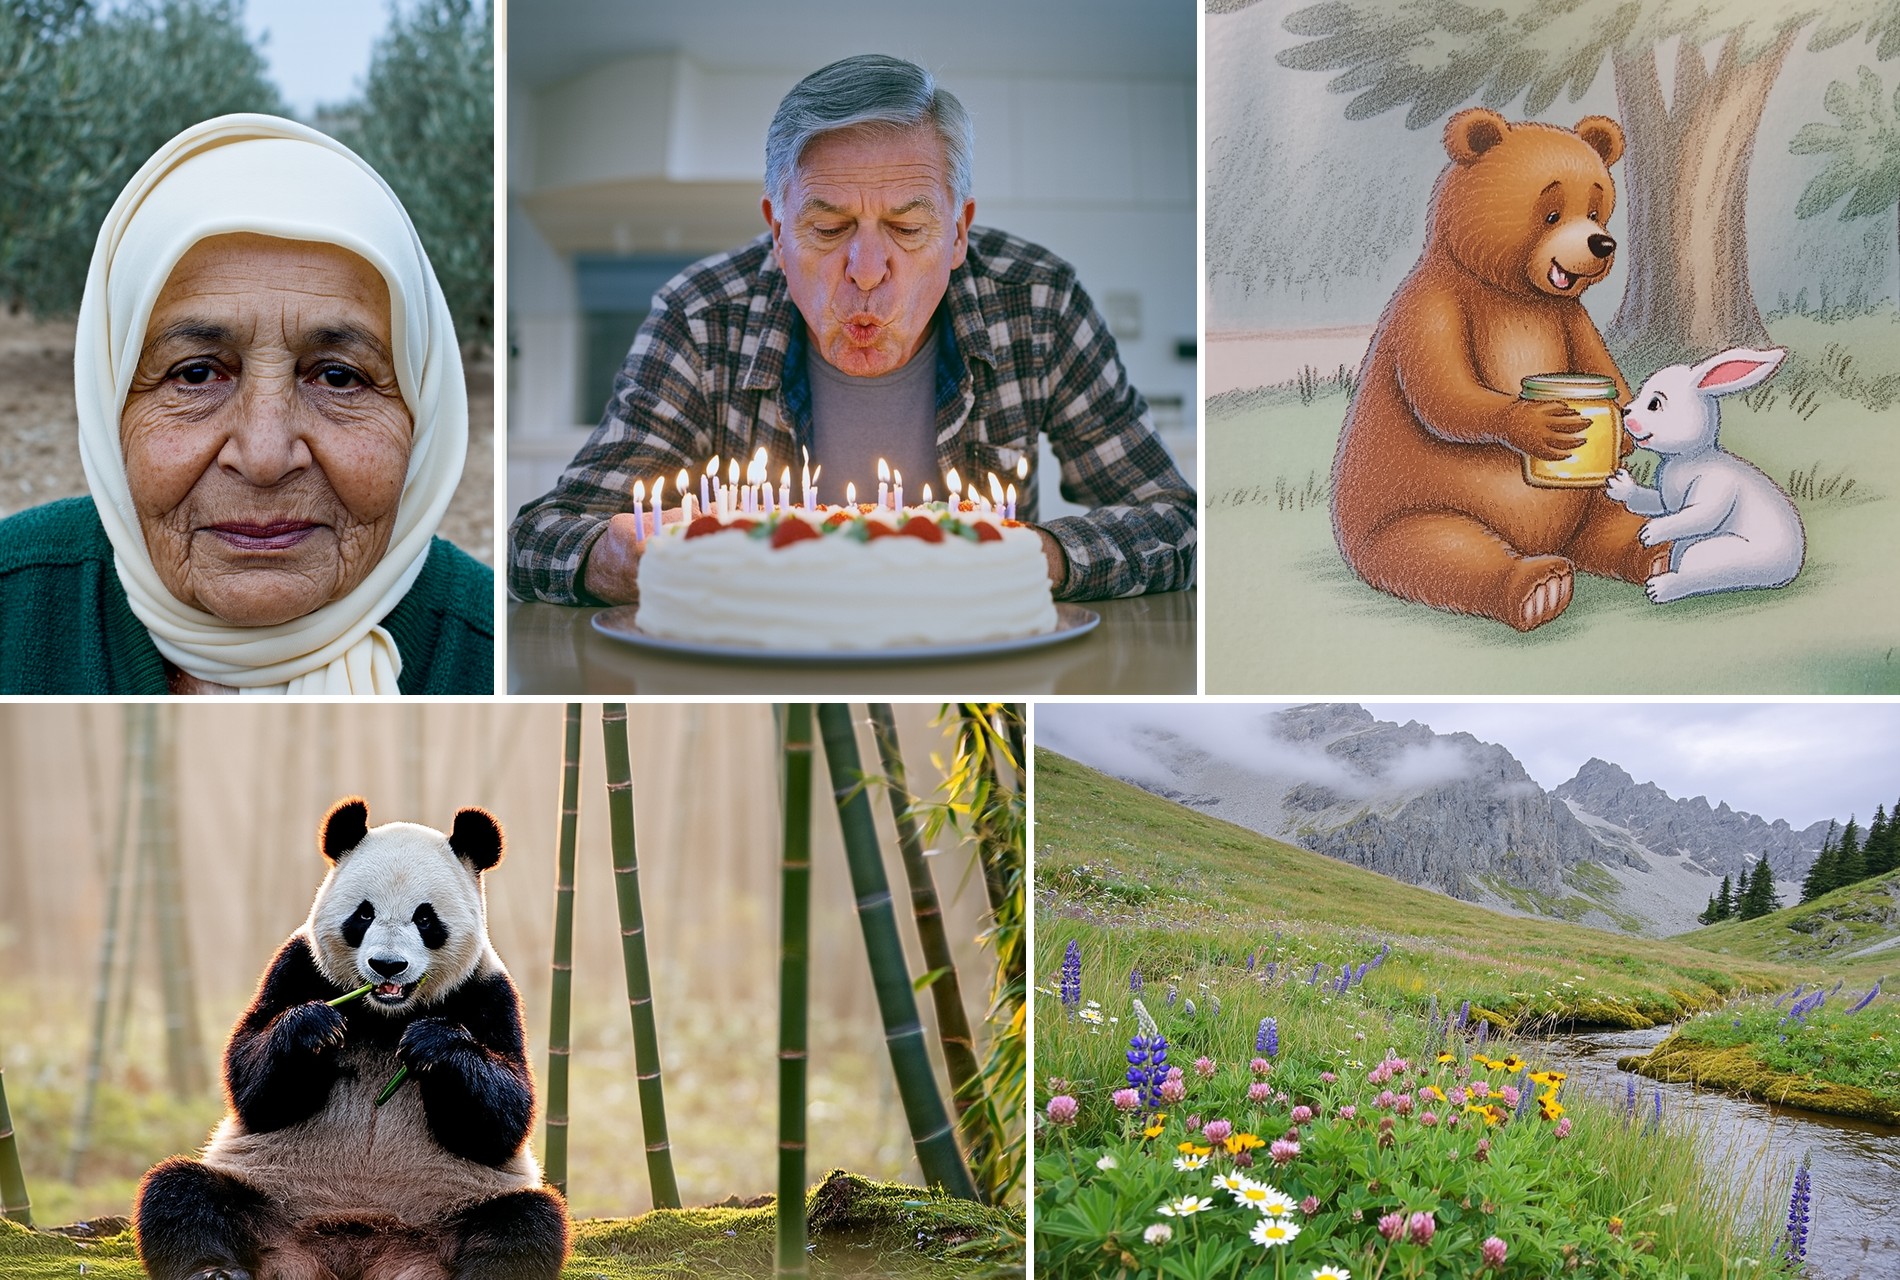
该模型无法可靠地生成文字,明确不适合制作海报。Linum还指出其在全身场景、群体和物理细节上的不足。封面展示的是开发者真实发布的模型生成样本,并非摄影作品或独立测试结果。
为何重要
可复现的检查点让效率主张能够接受检验。对创意团队而言,本地推理带来的控制权,需要以硬件、配置和质量审核投入为代价。低训练成本本身不能证明低生产成本或有竞争力的视频表现。
后续关注
后续应关注对训练成本和图像质量的独立复现,以及单独发布的视频检查点。
来源与核实
来源链接数量不等于独立证实次数。
01Linum — November 4 research announcement一手来源 · www.linum.ai · 2026年11月4日
02Linum — inference code, samples and limitations一手来源 · github.com · 2026年11月3日
03Linum — downloadable weights一手来源 · huggingface.co · 2026年11月4日
报告错误
帮助我们纠错
请指出争议陈述,并尽可能提供来源链接。请勿发送个人或敏感信息。