此文补充此前遗漏的报道。原始来源日期列于下方,并非今日新发布的消息。
发生了什么
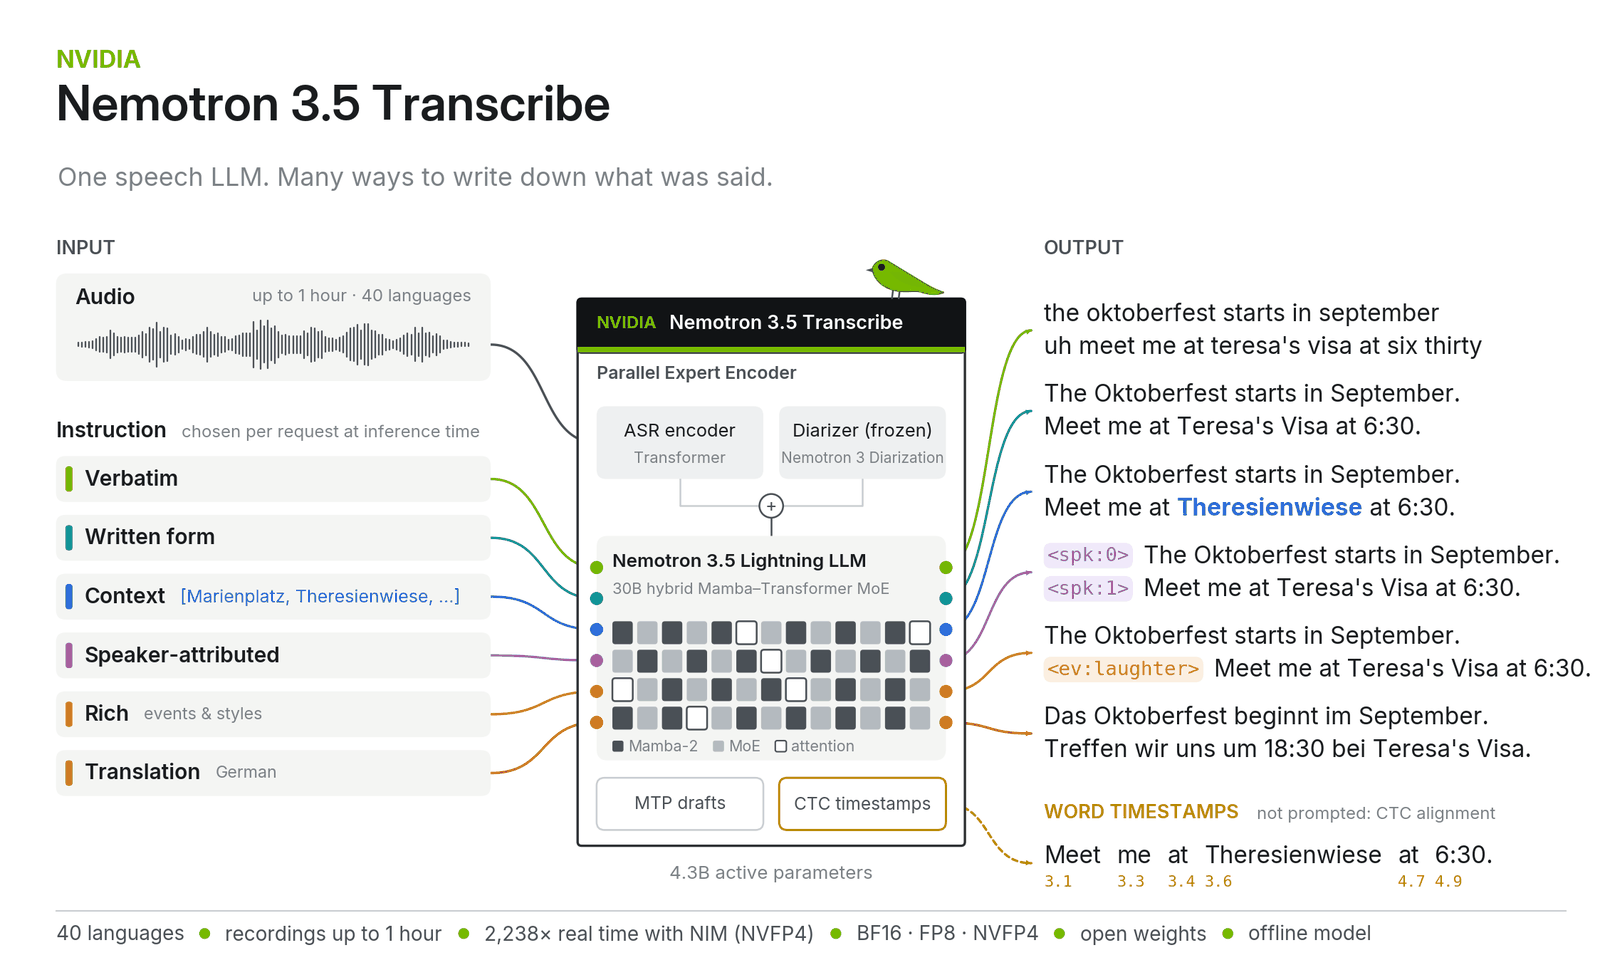
文档列出的任务包括逐字及整理式转录、上下文词汇处理、区分说话者的文本、翻译、语言识别和音频问答。可选的逐词时间戳有助于定位录音内容。模型卡列出适用OpenMDW-1.1的BF16、FP8和NVFP4版本。
技术报告解释说,可读的会议记录、逐字采访稿和含专业名称的转录,对同一段语音需要不同处理。一个增强了语音能力的模型响应这些指令,而不是预先固定所有转录规则。
这是离线处理录音的模型,而非完整的实时语音代理。说话者标签只能区分录音内的声音,不能确认现实中的身份。
为何重要
对联络中心、出版机构和内部知识系统而言,机会在于音频采集之后拥有更灵活的处理环节。实时语音代理还需要流式处理、对话管理和可靠的轮次交替;不能从一次转录模型发布推断其具备这些能力。
后续关注
应测试具有代表性的口音、背景噪声、重叠语音和专业词汇。除了词错误率,还应比较校正工作量及处理成本;在错误可能实质改变含义时,应保留人工复核。
来源与核实
来源链接数量不等于独立证实次数。
01NVIDIA — Nemotron 3.5 Transcribe model card一手来源 · huggingface.co · 2026年10月28日
02NVIDIA — Nemotron 3.5 Transcribe technical report一手来源 · research.nvidia.com · 2026年10月28日
报告错误
帮助我们纠错
请指出争议陈述,并尽可能提供来源链接。请勿发送个人或敏感信息。