Wat is er gebeurd
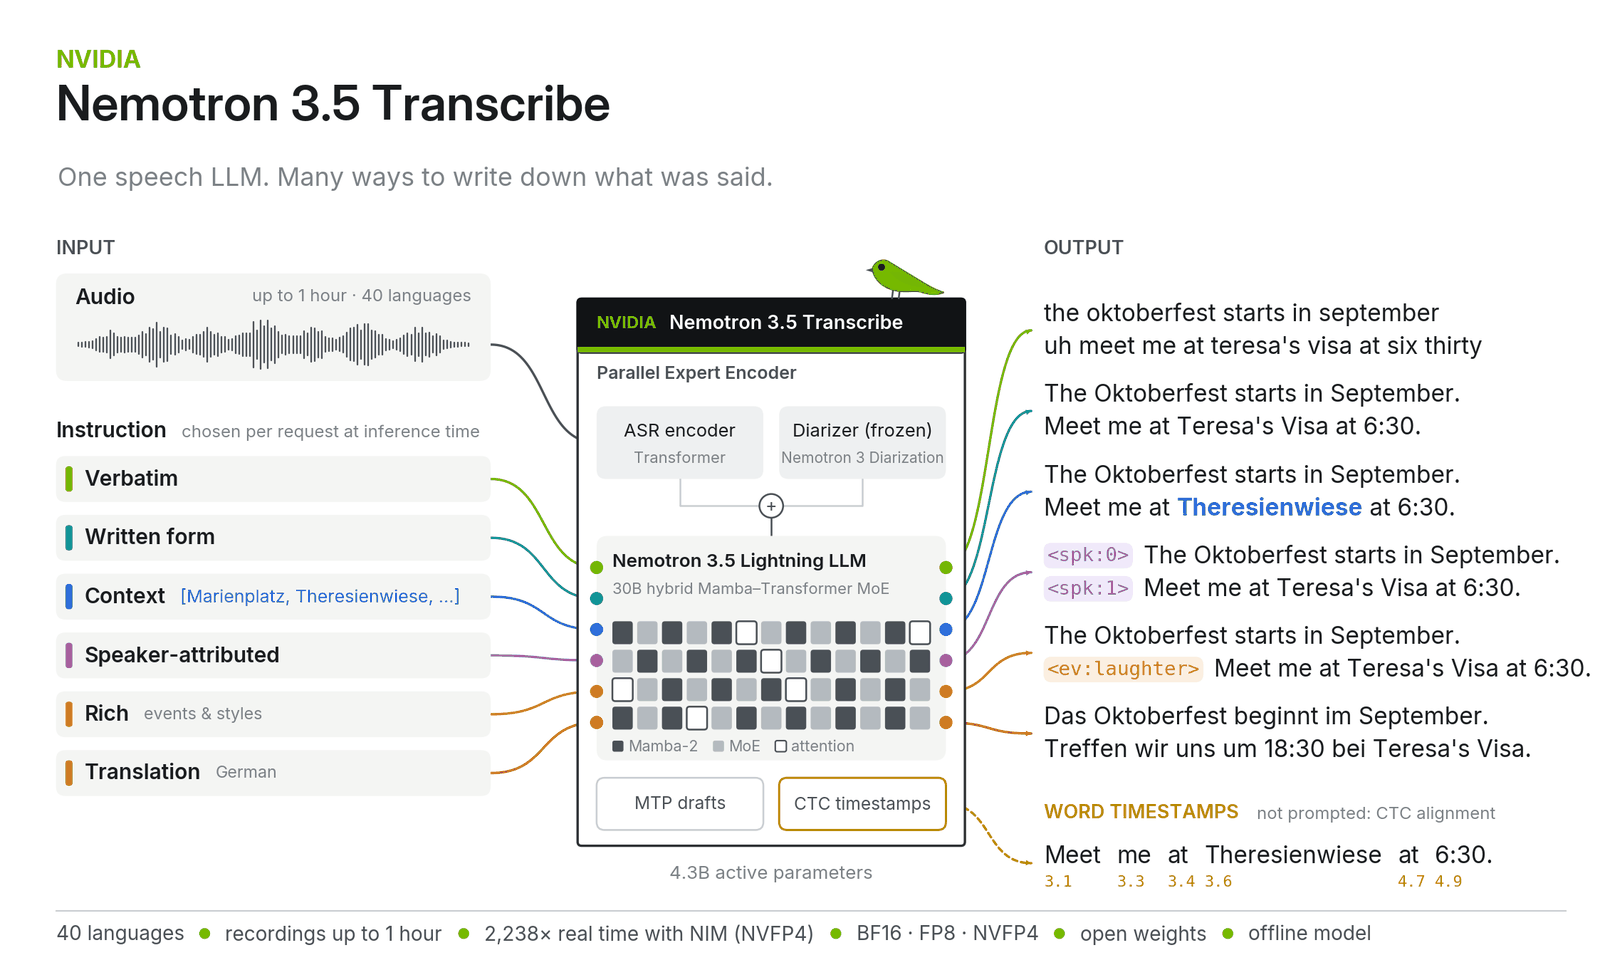
Gedocumenteerde taken zijn letterlijke en opgeschoonde transcriptie, contextuele woordenschat, tekst per spreker, vertaling, taalherkenning en vragen over audio. Optionele tijdstempels per woord helpen door opnamen navigeren. De modelkaart noemt BF16-, FP8- en NVFP4-uitgaven onder OpenMDW-1.1.
Het technische rapport legt uit dat een leesbaar vergaderverslag, een letterlijk interview en een transcript met vaktermen elk een andere verwerking van dezelfde spraak vereisen. Eén met spraak uitgebreid model reageert op deze instructies, in plaats van alle transcriptieregels vooraf vast te leggen.
Dit is een model voor offline verwerking van opnamen, geen complete live spraakagent. Sprekerlabels onderscheiden stemmen binnen een opname; ze stellen geen echte identiteit vast.
Waarom het belangrijk is
Voor contactcentra, uitgevers en interne kennissystemen ontstaat een beter aanpasbare verwerkingsstap nadat audio is opgenomen. Een live spraakagent vereist ook streaming, dialoogbeheer en betrouwbare beurtwisseling. Die mogelijkheden mogen niet worden afgeleid uit een transcriptierelease.
Wat we volgen
Test representatieve accenten, achtergrondlawaai, overlappende spraak en specialistische woordenschat. Vergelijk correctiewerk en verwerkingskosten naast woordfoutscores en behoud menselijke controle wanneer een fout de betekenis wezenlijk kan veranderen.
Bronnen en verificatie
Het aantal bronlinks is niet het aantal onafhankelijke bevestigingen.
01Meld een correctie
Help ons fouten te herstellen
Vermeld de betwiste uitspraak en zo mogelijk een bronlink. Stuur geen persoonlijke of gevoelige gegevens.